y から x へ引き直すと傾きが変わる〜単回帰分析と回帰の名前
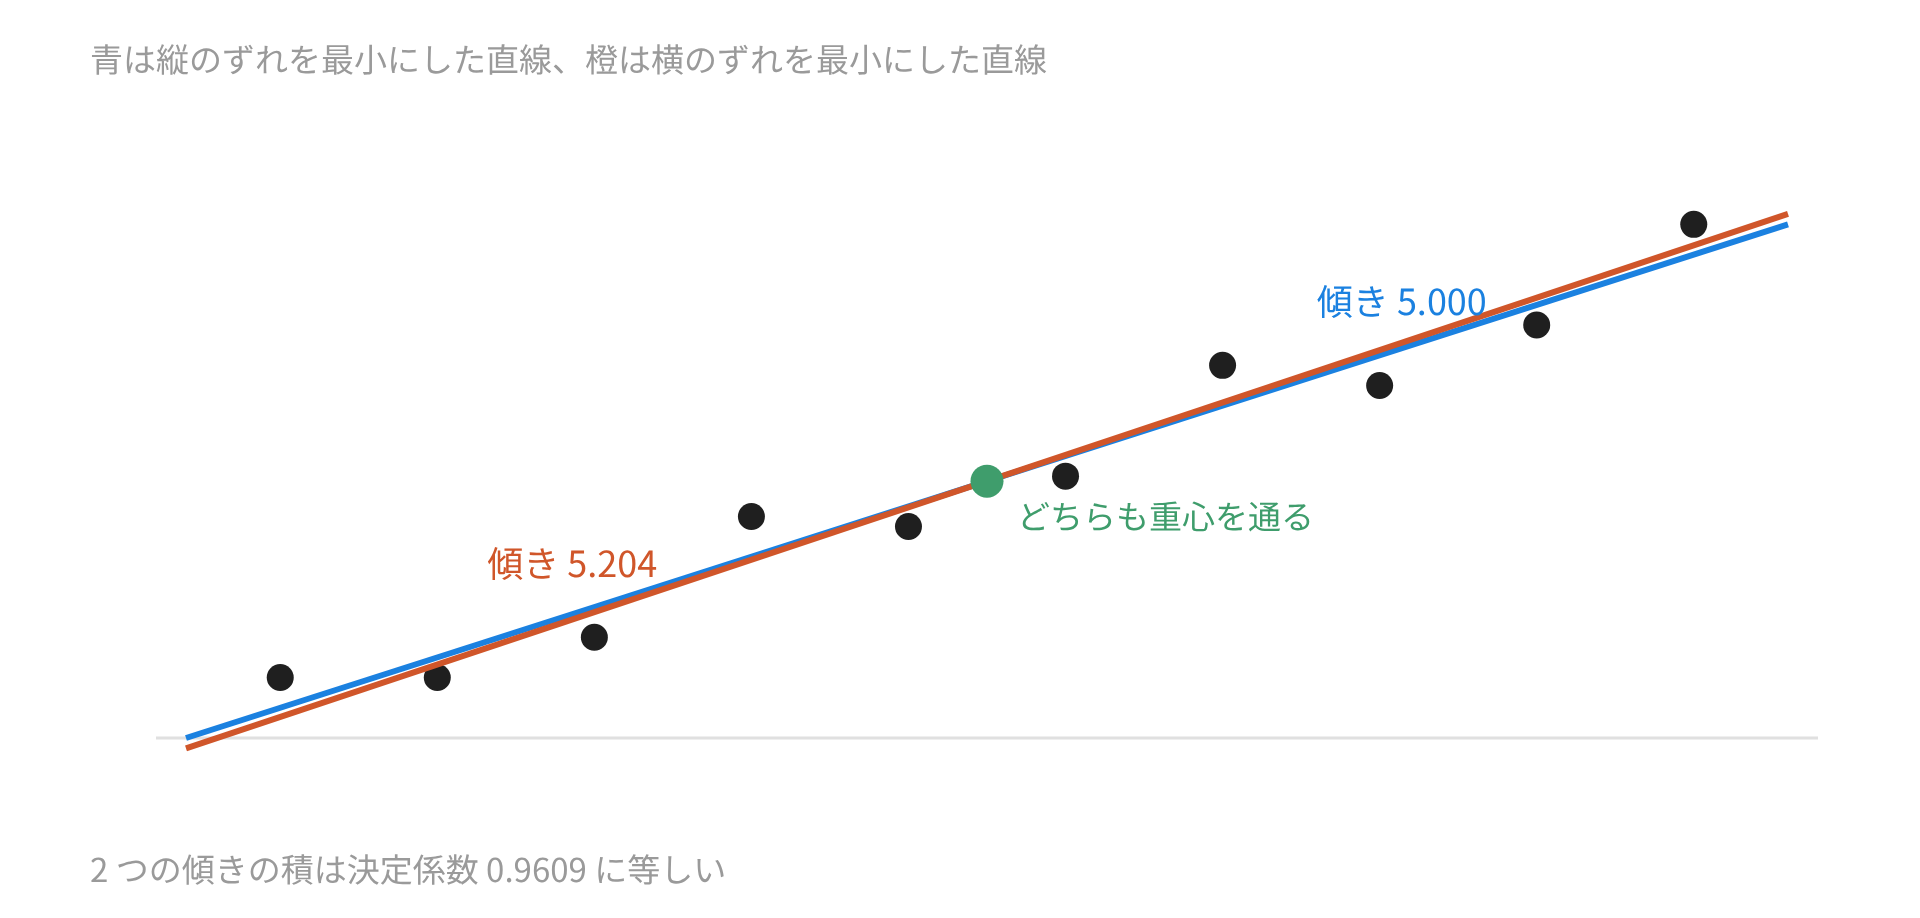
同じ 10 個の点に最小二乗法で直線を当てると、傾きは 5.000 になります。 と の役割を入れかえて引き直し、もとの軸へ戻すと 5.204。
データも方法も同じなのに、2 本の直線は重なりません。何を最小にしているかが違うためです。
この差が、回帰という名前の由来にもつながります。
何を最小にしているのか
説明変数 と目的変数 の関係を、次の形で表します[1]。
は誤差で、平均 、分散 を持つとします。 のほうは誤差なしで測れているという扱いです。
最小二乗法が小さくするのは、点から直線までの縦方向のずれの 2 乗和です[1]。
縦だけ、というところが要点です。点と直線の最短距離ではありません。 の予測誤差だけを問題にしています。
解のかたち
を と で偏微分して と置くと、次が出ます[2]。
分子は と が一緒に動く量、分母は だけが動く量です。共分散を の分散で割った形になっている。
切片の式は、直線が必ず を通ることを言っています。重心を通る直線を、傾きだけ選んでいる。
例:10 個の点から求める
を 1 から 10、 を 38、38、42、54、53、58、69、67、73、83 とします。
平均は 、 です。3 つの平方和を出します。
| 量 | 値 |
|---|---|
| 82.5 | |
| 2146.5 | |
| 412.5 |
傾きは 、切片は 。
が 1 増えると が 5.00 増える、と読みます。単位のある量なら、傾きにも単位がつく。
残差
各点での実際の値と予測値の差を残差といいます。この例では次のようになります。
合計が になるのは偶然ではありません。 で微分して と置いた式が、そのまま残差の和が という条件です。
残差の標準偏差は 。割る数が なのは、傾きと切片の 2 つを推定に使ったためです[2]。
決定係数
の全変動を、直線で説明できた部分と残った部分に分けます。
説明できた割合が決定係数です。。
相関係数 は 0.9802 で、2 乗すると決定係数に一致します。単回帰では と決定係数が同じ数になる。
高い値が出ても、直線が正しいという意味ではありません。曲がった関係でも、範囲が狭ければ は高く出ます。
傾きが でないといえるか
の標準誤差は、残差の標準偏差を で割った値です。
で、自由度は 。両側の p 値は です。
95% 信頼区間は で 。傾きが 5 ちょうどだと決まったわけではありません。
が分母にあることに意味があります。 の散らばりが大きいほど傾きの推定が安定する。狭い範囲のデータで傾きを論じると、誤差が大きくなります。
点数を増やすより、 の範囲を広げるほうが傾きの精度に効くことがあります。 は の散らばりそのものだからです。
同じ でも、 が 1 から 10 まで散っている場合と 5 から 6 に固まっている場合では、精度がまるで違う。
2 本の直線が一致しない
と を入れかえて、 を で説明する直線も引けます。傾きは 。
これを について解き直すと、- の平面では傾き になります。もとの 5.000 と一致しません。
2 つの傾きを掛けると で、決定係数に等しくなります。
は 1 以下なので、2 本の直線は必ずずれます。一致するのは点が完全に一直線に並ぶときだけ。
縦のずれを小さくする直線と、横のずれを小さくする直線は別物、というだけの話です。
「回帰」という名前
名前はゴルトンの実験から来ています。1875 年ごろにスイートピーの種でおこなった観察です[4]。
大きい種から採れた次の世代は親より小さく、小さい種からは親より大きいものが採れた。平均のほうへ戻る、という現象です。
はじめ彼はこれを reversion と呼び、のちに regression と呼びかえました[4]。1889 年の『Natural Inheritance』でまとめられ、ピアソンに強い影響を与えています[4]。
平均へ戻るように見えるのは、傾きが より小さくなるためです。標準化した変数どうしなら傾きは に等しく、 ならつねに を割ります。
親が平均より 単位高くても、子の予測は 単位ぶんしか高くない。逆向きに回帰すると同じことが反対側でも起きるので、どちらから見ても「戻る」ように見えます。
直線の外へは伸ばさない
得られた式は、データがあった の範囲でだけ意味を持ちます。 から で当てた直線を に使う根拠はどこにもない。
切片も同じです。この例の 30.0 は での予測値ですが、 のデータは 1 つもありません。
切片に意味があるのは、 がデータの範囲に入っているときだけです。範囲の外なら、直線を伸ばした先の数字にすぎません。
、、 のとき、決定係数はいくつですか。
- 0.75
- 0.50
- 3.00
傾きは単位のある量、決定係数は単位のない割合、残差は 1 点ごとのずれ。3 つを並べて見ると、直線が何を言っていて何を言っていないかが分かります。
参考文献
傾きは 150/50=3、相関係数は 150/50×600=150/173.2=0.866 です。決定係数はその 2 乗で 0.75。傾きの 3 は決定係数とは別の量で、単位によっていくらでも変わります。